Las tarjetas gráficas NVIDIA pueden acelerarse casi el doble: los entusiastas han encontrado el potencial oculto de las RTX 30, RTX 40 y RTX 20
Traducido con IA del original en ruso.
Los entusiastas han encontrado una manera de duplicar el rendimiento de los cálculos matriciales en las tarjetas gráficas NVIDIA RTX 20, RTX 30 y RTX 40, lo que es especialmente útil para trabajar con modelos de IA locales.
Las tarjetas gráficas NVIDIA antiguas son capaces de realizar algunos cálculos casi el doble de rápido gracias a modificaciones que revelan el potencial oculto de las RTX 30, RTX 40 y RTX 20 sin cambiar los controladores.
Ambas modificaciones afectan a los cálculos matriciales, importantes para la IA. En la arquitectura Ampere (RTX 30), se logró desbloquear el procesamiento acelerado de instrucciones FP/BF16 FMA con acumulación FP32. Como resultado, el rendimiento de la RTX 3090 Ti en la multiplicación de matrices BF16 aumentó de 87,5 a 157,4 TFLOPS, aproximadamente un 80%.
Un truco similar funcionó en Ada Lovelace: en la RTX 4090, el rendimiento de los núcleos tensoriales FP16 aumentó de 165,6 a 331,6 TFLOPS. La modificación también abarca la RTX 20: el resultado de la RTX 2080 Ti aumentó de 59,9 a 111 TFLOPS. Para los modelos de lenguaje locales, esto puede acelerar el trabajo en aproximadamente un 33-36%.
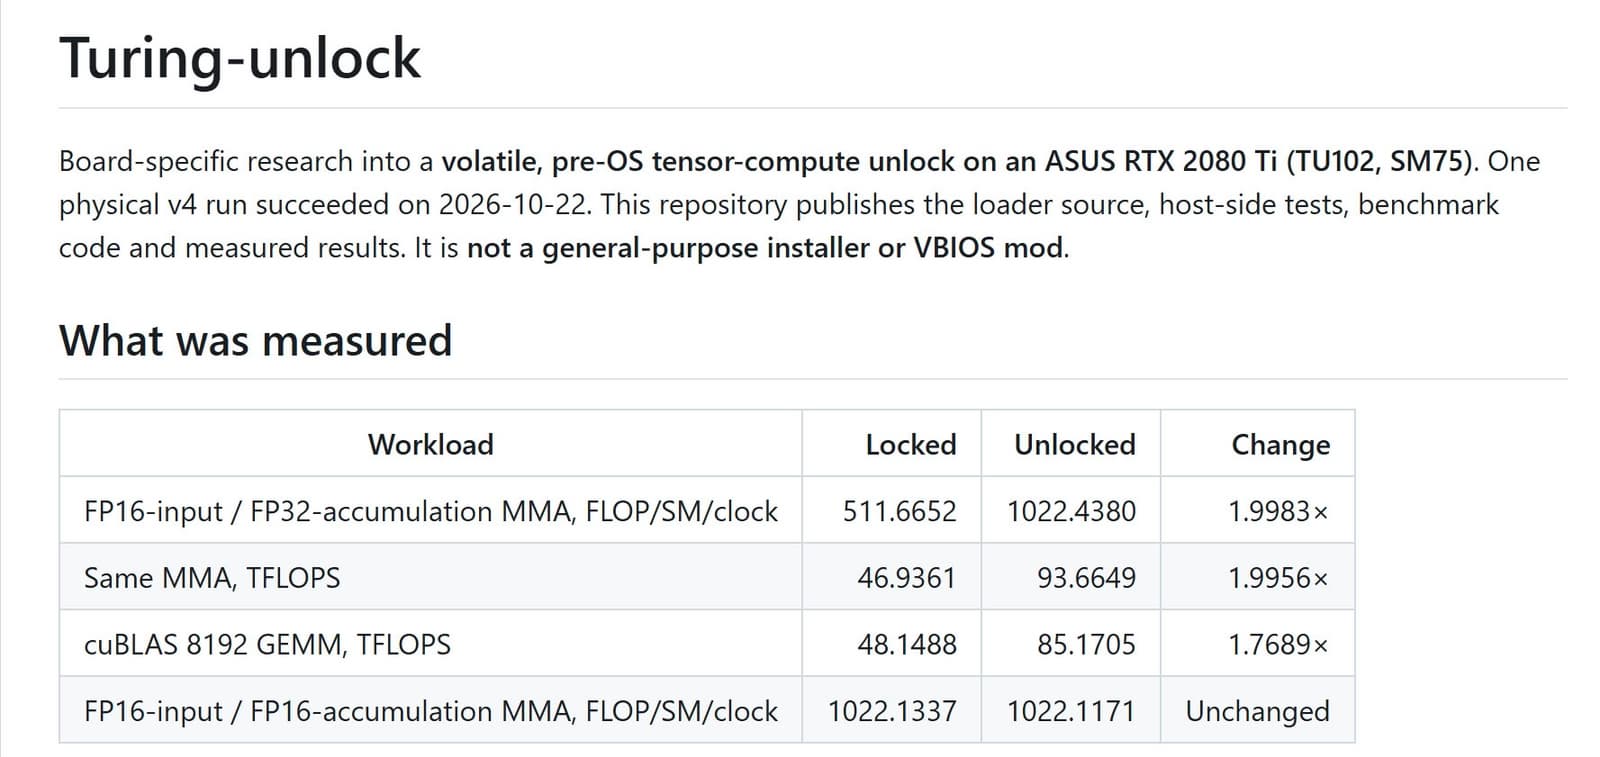
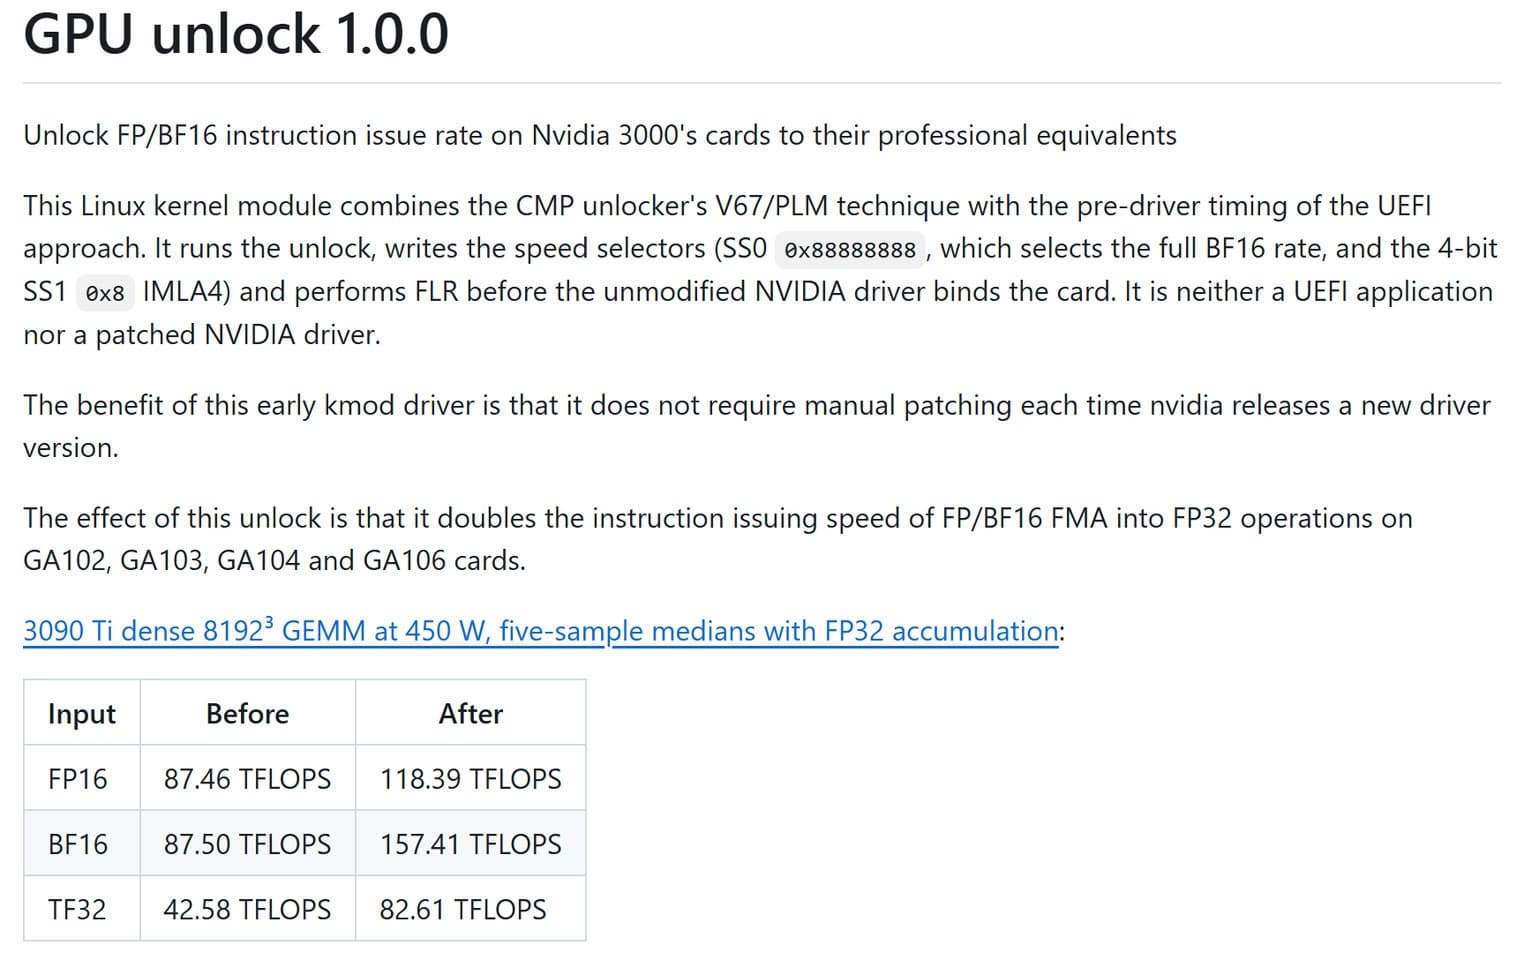
Las modificaciones funcionan con controladores estándar, pasan las pruebas CUDA y aceleran principalmente las tareas de IA, así como los cálculos matriciales complejos, y no los juegos. La activación requiere un inicio al arrancar el sistema y la garantía puede ser anulada.
No te pierdas nuestras noticiasAñade este sitio a tus fuentes preferidas para vernos más a menudoAñadir en Google